
Ứng dụng theo dõi chu kỳ kinh nguyệt sử dụng dữ liệu thế nào?
Mục lục
- Dữ liệu nào được ứng dụng dùng để dự đoán chu kỳ?
- Ứng dụng biến dữ liệu lịch sử thành dự đoán như thế nào?
- Vì sao dự đoán có thể thay đổi sau mỗi lần người dùng cập nhật dữ liệu?
- Dữ liệu không đều ảnh hưởng đến kết quả dự đoán ra sao?
- Dữ liệu dùng để dự đoán ngày kinh có giống dữ liệu dùng để dự đoán rụng trứng không?
- Ứng dụng theo dõi chu kỳ kinh nguyệt có thể dự đoán chính xác tuyệt đối không?
- Hiểu dữ liệu của ứng dụng theo cách nào là đúng?
Ứng dụng theo dõi chu kỳ kinh nguyệt dùng dữ liệu ngày bắt đầu kỳ kinh, lịch sử chu kỳ và một số chỉ dấu được người dùng ghi nhận để ước tính các mốc tiếp theo. Độ chính xác phụ thuộc vào mức độ đầy đủ, ổn định của dữ liệu và cách từng ứng dụng xây dựng mô hình dự đoán
Ứng dụng theo dõi chu kỳ kinh nguyệt không chỉ lấy ngày dự kiến có kinh tiếp theo từ một phép tính cố định. Về bản chất, ứng dụng thu thập các lần ghi nhận của người dùng, biến chúng thành lịch sử chu kỳ rồi dùng quy luật của dữ liệu đó để ước tính mốc tương lai. Nghiên cứu về mô hình dự đoán ngày bắt đầu chu kỳ tiếp theo cho thấy mô hình có thể kết hợp lịch sử chu kỳ của từng người với thông tin ở quy mô quần thể, đồng thời cập nhật dự đoán khi chu kỳ hiện tại tiếp diễn.
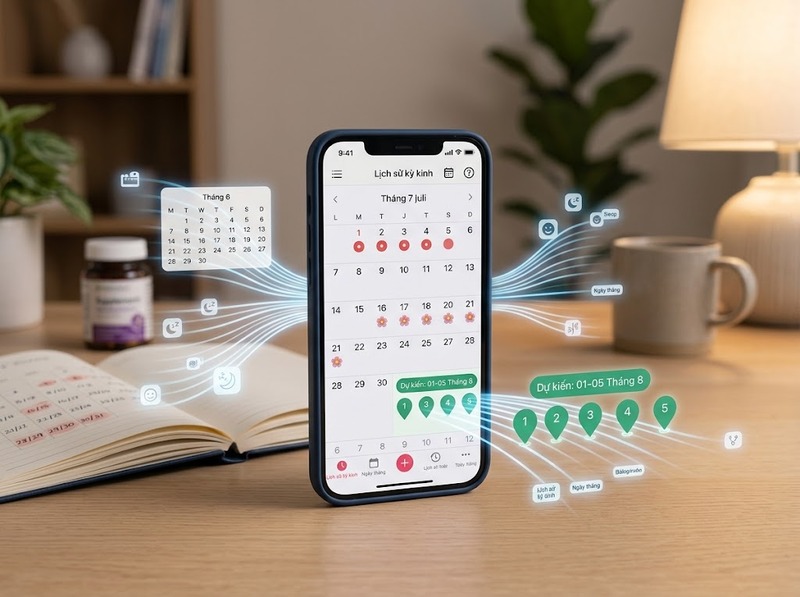
Ứng dụng thường xử lý dữ liệu theo một chuỗi logic: ghi nhận dữ liệu đầu vào → xác định đặc điểm của các chu kỳ trước → ước tính chu kỳ tiếp theo → cập nhật dự đoán khi có dữ liệu mới. Tuy nhiên, cách làm cụ thể không giống nhau giữa mọi ứng dụng; một số mô hình chủ yếu dựa vào dữ liệu tự khai báo, trong khi những hệ thống khác có thể kết hợp thêm dữ liệu sinh trắc học hoặc thiết bị đeo.
Dữ liệu nào được ứng dụng dùng để dự đoán chu kỳ?
Dữ liệu quan trọng nhất thường là lịch sử ngày bắt đầu và độ dài các chu kỳ trước đó. Từ các mốc này, hệ thống có thể nhận diện khoảng thời gian mà chu kỳ của một người thường dao động và dùng nó làm cơ sở cho dự đoán tiếp theo. Một nghiên cứu sử dụng hơn 186.000 người và hơn 2 triệu chu kỳ được theo dõi cho thấy mô hình có thể học lịch sử độ dài chu kỳ cá nhân và đồng thời tận dụng thông tin ở cấp độ quần thể.
Ngoài dữ liệu về kỳ kinh, một số ứng dụng có thể sử dụng thông tin bổ sung do người dùng nhập hoặc dữ liệu từ thiết bị theo dõi. Các nghiên cứu về ứng dụng theo dõi khả năng sinh sản ghi nhận việc sử dụng dữ liệu chu kỳ tự báo cáo cùng dữ liệu sinh trắc học; một nghiên cứu khác đã thử kết hợp nhiệt độ cơ thể cơ bản và nhịp tim với thuật toán học máy để dự đoán kỳ kinh và cửa sổ dễ thụ thai.
Điểm quan trọng là dữ liệu đầu vào không có giá trị chỉ vì số lượng nhiều. Nếu người dùng bỏ sót ngày ghi nhận, lịch sử quan sát có thể không phản ánh đầy đủ chu kỳ thực tế. Vì vậy, mô hình dự đoán tốt cần tính đến cả hành vi theo dõi dữ liệu, thay vì xem mọi khoảng thời gian không được nhập là một tín hiệu sinh lý chắc chắn.
Ứng dụng biến dữ liệu lịch sử thành dự đoán như thế nào?
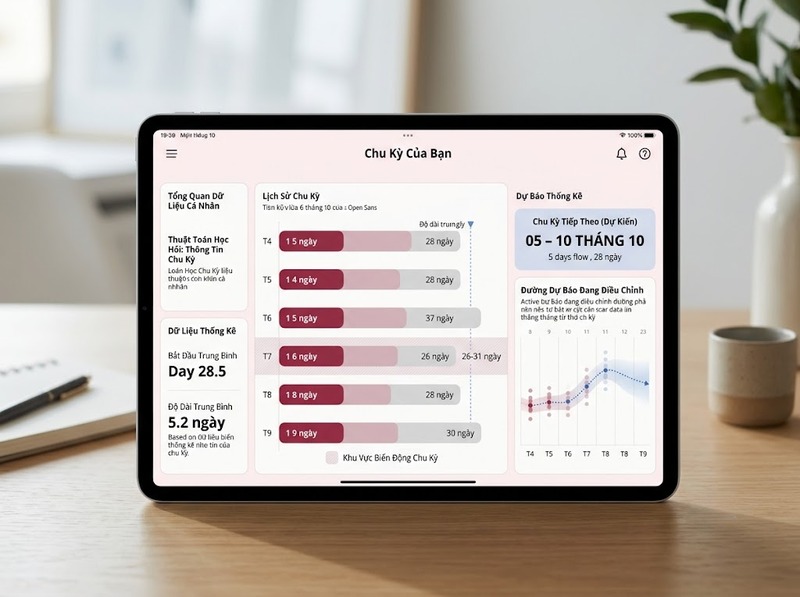
Cơ chế cơ bản là tìm quy luật trong lịch sử của cùng một người. Chẳng hạn, nếu các chu kỳ trước có độ dài tương đối gần nhau, hệ thống có thể dùng đặc điểm đó để ước tính thời điểm bắt đầu chu kỳ kế tiếp. Khi có thêm dữ liệu mới, dự đoán có thể được điều chỉnh thay vì giữ nguyên một con số ban đầu. Mô hình được nghiên cứu bởi nhóm Columbia cho phép cập nhật dự đoán theo diễn tiến của từng chu kỳ và tính đến khả năng người dùng bỏ sót việc ghi nhận.
Ở cấp độ phức tạp hơn, thuật toán có thể kết hợp hai lớp thông tin: dữ liệu riêng của cá nhân và mẫu hình quan sát được từ nhiều người khác. Cách kết hợp này giúp mô hình không chỉ dựa vào một vài chu kỳ riêng lẻ của người dùng mà còn có thêm thông tin tham chiếu khi dữ liệu cá nhân còn hạn chế.
Một số hệ thống còn thử sử dụng dữ liệu sinh lý như nhiệt độ cơ thể cơ bản hoặc nhịp tim. Trong nghiên cứu trên người có chu kỳ đều, mô hình kết hợp hai chỉ dấu này đạt độ chính xác dự đoán kỳ kinh 89,60%; ở nhóm có chu kỳ không đều, độ chính xác giảm xuống 75,90%, cho thấy dữ liệu sinh lý và thuật toán vẫn không loại bỏ được hoàn toàn tác động của biến thiên chu kỳ.
Vì sao dự đoán có thể thay đổi sau mỗi lần người dùng cập nhật dữ liệu?
Dự đoán là một ước tính dựa trên dữ liệu đã quan sát, không phải lịch cố định. Khi người dùng ghi nhận một kỳ kinh mới hoặc bổ sung dữ liệu cho chu kỳ hiện tại, ứng dụng có thêm thông tin để đánh giá lại khoảng thời gian dự kiến.
Một nghiên cứu về mô hình dự đoán ngày bắt đầu chu kỳ tiếp theo cho thấy dự đoán có thể được cập nhật khi chu kỳ tiến triển. Mô hình đồng thời ước tính xác suất người dùng đã bỏ sót việc ghi nhận để phân biệt sai khác do hành vi theo dõi với biến động thực tế của chu kỳ.
Điều này giải thích vì sao cùng một người có thể thấy ngày dự đoán thay đổi giữa các lần mở ứng dụng. Thay đổi đó không nhất thiết có nghĩa ứng dụng “tính sai”; nó có thể phản ánh việc mô hình vừa nhận được dữ liệu mới và điều chỉnh ước tính.
Dữ liệu không đều ảnh hưởng đến kết quả dự đoán ra sao?
Độ tin cậy của dự đoán phụ thuộc đáng kể vào chất lượng dữ liệu đầu vào. Khi người dùng bỏ sót ngày bắt đầu kỳ kinh hoặc ghi nhận không nhất quán, ứng dụng phải dựa trên một lịch sử không hoàn chỉnh. Nghiên cứu về mô hình dự đoán chu kỳ đã xem việc tuân thủ theo dõi là một yếu tố riêng vì dữ liệu thu được từ ứng dụng có thể khác với chu kỳ thực tế nếu người dùng không ghi chép đều.
Chu kỳ không đều cũng tạo ra một giới hạn quan trọng. Một nghiên cứu kiểm tra các ứng dụng theo dõi kỳ kinh cho thấy dự đoán ngày kinh chính xác khó hơn ở người có chu kỳ không đều; trong nhóm được thử nghiệm, sai lệch dự đoán có thể kéo dài từ vài ngày và lớn hơn ở người có biến động chu kỳ cao.
Vì vậy, một ứng dụng có thể đưa ra ngày dự kiến rất cụ thể nhưng độ chắc chắn của ngày đó không nên được hiểu là tuyệt đối. Con số hiển thị là kết quả của mô hình trên dữ liệu đã có, và độ chính xác có thể thay đổi theo từng người.
Dữ liệu dùng để dự đoán ngày kinh có giống dữ liệu dùng để dự đoán rụng trứng không?
Không hoàn toàn. Dự đoán ngày bắt đầu kỳ kinh chủ yếu có thể dựa vào lịch sử độ dài chu kỳ và cách chu kỳ diễn tiến. Trong khi đó, dự đoán rụng trứng hoặc cửa sổ dễ thụ thai có thể cần thêm thông tin về các dấu hiệu sinh lý.
Một tổng quan nghiên cứu về các ứng dụng dự đoán khả năng sinh sản ghi nhận các ứng dụng có thể sử dụng thuật toán độc quyền, dữ liệu chu kỳ do người dùng tự báo cáo và dữ liệu sinh trắc học.
Đây cũng là lý do không nên mặc định rằng một ứng dụng dự đoán ngày kinh tốt thì sẽ dự đoán thời điểm rụng trứng với cùng độ chính xác. Trong nghiên cứu kết hợp nhiệt độ cơ thể cơ bản và nhịp tim, hiệu quả dự đoán ở người có chu kỳ không đều thấp hơn đáng kể so với nhóm có chu kỳ đều.
Ứng dụng theo dõi chu kỳ kinh nguyệt có thể dự đoán chính xác tuyệt đối không?
Không. Dữ liệu lịch sử giúp nhận diện quy luật nhưng không biến một chu kỳ sinh học biến thiên thành một lịch cố định.
Ngay cả các nghiên cứu xây dựng mô hình chuyên biệt cũng phải xử lý những nguồn sai lệch như dữ liệu bị bỏ sót, khác biệt giữa từng cá nhân và biến động của chu kỳ. Khi dữ liệu theo dõi không đầy đủ hoặc chu kỳ không đều, kết quả có thể kém ổn định hơn.
Vì vậy, nên hiểu dự đoán của ứng dụng là ước tính dựa trên dữ liệu, không phải một mốc chắc chắn về mặt sinh lý. Đặc biệt, các mốc liên quan đến rụng trứng hoặc cửa sổ dễ thụ thai cần được xem xét thận trọng hơn nếu chỉ dựa trên lịch sử chu kỳ hoặc thuật toán của ứng dụng.
Hiểu dữ liệu của ứng dụng theo cách nào là đúng?
Có thể hình dung toàn bộ quá trình như sau:
Dữ liệu được ghi nhận → Lịch sử chu kỳ → Mẫu hình cá nhân → Mô hình dự đoán → Cập nhật khi có dữ liệu mới
Giá trị của ứng dụng nằm ở khả năng biến những lần ghi nhận rời rạc thành một ước tính có hệ thống. Độ tin cậy của kết quả lại phụ thuộc vào ba yếu tố chính: dữ liệu có đủ và nhất quán hay không, mô hình có xử lý tốt biến động cá nhân hay không, và loại mốc đang được dự đoán là ngày kinh hay một chỉ dấu khó suy ra hơn như rụng trứng.
Ứng dụng theo dõi chu kỳ kinh nguyệt sử dụng dữ liệu chủ yếu để học lịch sử và biến động của chu kỳ, sau đó ước tính các mốc tương lai và điều chỉnh chúng khi xuất hiện dữ liệu mới. Dự đoán có tính tham khảo, không phải lịch sinh lý cố định; chất lượng dữ liệu cá nhân và mức độ biến thiên của chu kỳ có ảnh hưởng trực tiếp đến kết quả.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm

