
AI trong ứng dụng sức khỏe tạo gợi ý thế nào?
Mục lục
- Dữ liệu nào được AI dùng để hiểu người dùng?
- AI biến dữ liệu thô thành thông tin có ý nghĩa ra sao?
- Hệ thống chọn một gợi ý cá nhân hóa bằng cách nào?
- Vì sao cùng một người có thể nhận gợi ý khác nhau theo thời gian?
- Độ chính xác của gợi ý phụ thuộc vào những yếu tố nào?
- Khi nào nên xem gợi ý AI là tham khảo thay vì kết luận?
AI trong ứng dụng sức khỏe không đơn giản “đọc” một chỉ số rồi đưa ra lời khuyên. Hệ thống thường phải thu thập dữ liệu, chuẩn hóa tín hiệu, nhận diện mẫu, đặt kết quả vào bối cảnh từng người và liên tục điều chỉnh theo dữ liệu mới. Cách gợi ý được tạo ra vì thế phụ thuộc cả vào chất lượng dữ liệu, mô hình AI, mục tiêu của ứng dụng và giới hạn an toàn mà nhà phát triển đặt ra.
Một ứng dụng sức khỏe có AI thường tạo gợi ý bằng cách biến dữ liệu thô thành một chuỗi suy luận có cấu trúc: thu thập dữ liệu → xử lý dữ liệu → trích xuất đặc trưng → nhận diện mẫu → ước lượng trạng thái hoặc nhu cầu → chọn gợi ý phù hợp → theo dõi phản hồi để điều chỉnh.
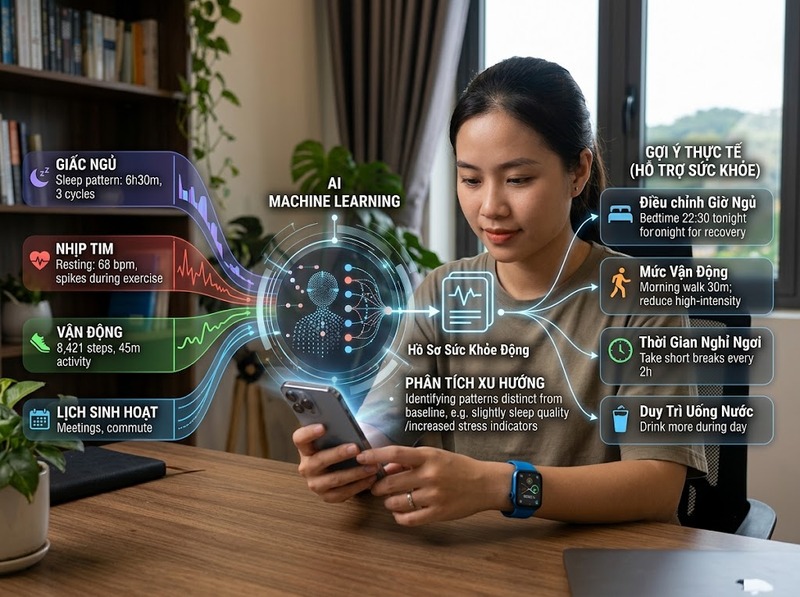
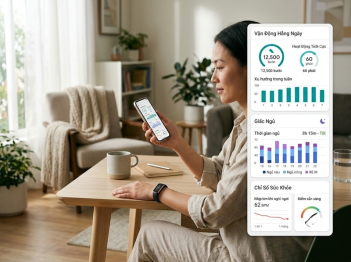
Ví dụ, thay vì chỉ thấy người dùng ngủ 6 giờ, hệ thống có thể xem đồng thời thời lượng ngủ nhiều ngày, giờ đi ngủ, mức vận động, nhịp tim, lịch sinh hoạt và mục tiêu cá nhân. AI sau đó tìm xem mẫu hiện tại khác với mức nền của chính người đó như thế nào rồi mới quyết định có nên nhắc đi ngủ sớm hơn, giảm cường độ vận động hoặc duy trì thói quen hiện tại.
Điểm quan trọng là cá nhân hóa không đồng nghĩa với chẩn đoán. Một ứng dụng có thể dùng AI để điều chỉnh lời nhắc vận động hoặc thói quen ngủ mà không đủ cơ sở để kết luận người dùng mắc bệnh. WHO cũng nhấn mạnh rằng AI trong y tế phụ thuộc mạnh vào chất lượng, tính đại diện và cách quản trị dữ liệu; dữ liệu thiên lệch hoặc không phù hợp có thể tạo ra đầu ra sai lệch dù mô hình xử lý rất phức tạp.
Dữ liệu nào được AI dùng để hiểu người dùng?
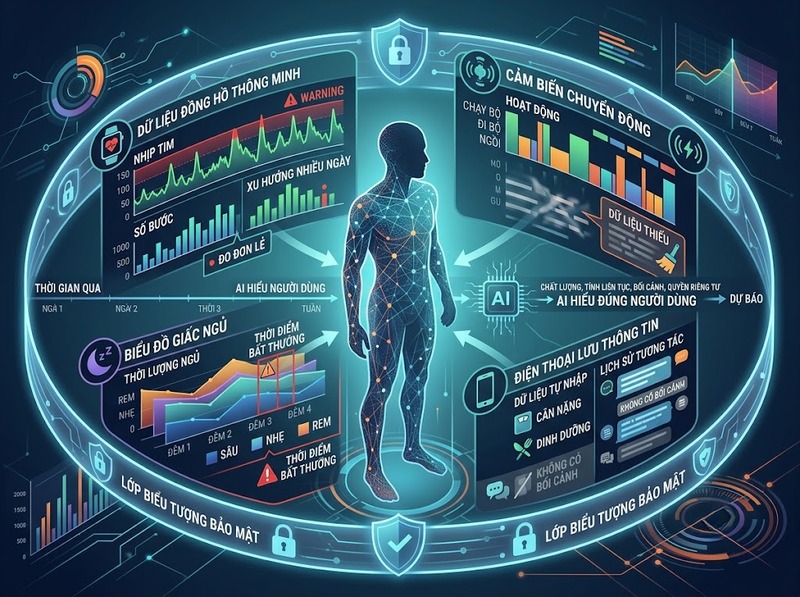
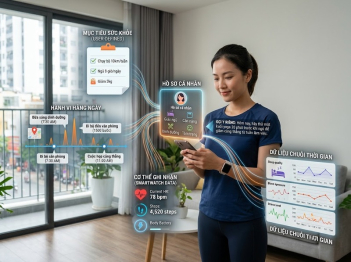
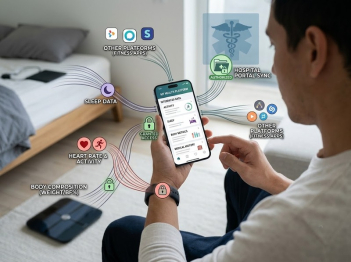
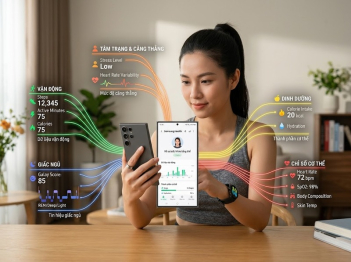
AI chỉ có thể cá nhân hóa dựa trên những tín hiệu mà ứng dụng được phép tiếp nhận. Với ứng dụng sức khỏe và thiết bị đeo, dữ liệu có thể bao gồm số bước, nhịp tim, thời gian vận động, thời lượng ngủ, dữ liệu cảm biến sinh lý, thông tin người dùng tự nhập hoặc lịch sử tương tác với ứng dụng.
Các thiết bị đeo hiện nay có thể tạo ra nhiều loại tín hiệu khác nhau, từ dữ liệu chuyển động đến các tín hiệu sinh học như điện tim hoặc các chỉ dấu sinh lý khác tùy loại cảm biến. Machine learning được sử dụng để rút ra những đặc trưng có ý nghĩa từ lượng dữ liệu liên tục này thay vì xử lý từng điểm đo độc lập.
Tuy nhiên, nhiều dữ liệu hơn không tự động tạo ra gợi ý tốt hơn. Ba yếu tố quan trọng là chất lượng, bối cảnh và tính liên tục.
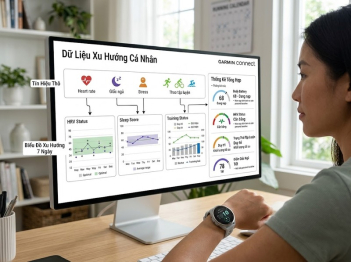
Một giá trị nhịp tim đơn lẻ chẳng hạn có thể ít ý nghĩa nếu hệ thống không biết người dùng đang nghỉ, vừa tập thể dục hay thiết bị vừa bị lỏng. Tương tự, thời lượng ngủ một đêm khó phản ánh xu hướng bằng dữ liệu của nhiều ngày. Vì vậy ứng dụng thường cần làm sạch dữ liệu, xử lý điểm thiếu hoặc bất thường và đặt từng tín hiệu vào chuỗi thời gian trước khi chuyển sang bước phân tích.
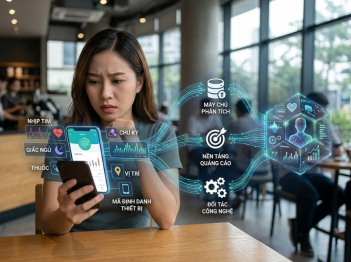
Dữ liệu cá nhân cũng tạo ra một giới hạn khác: quyền riêng tư. WHO coi bảo vệ quyền tự chủ, quyền riêng tư, tính minh bạch và trách nhiệm giải trình là những điều kiện quan trọng khi phát triển AI cho sức khỏe. Một mô hình có khả năng dự đoán tốt vẫn không phải là mô hình được sử dụng hợp lý nếu dữ liệu đầu vào được thu thập hoặc xử lý thiếu kiểm soát.
AI biến dữ liệu thô thành thông tin có ý nghĩa ra sao?
Sau khi nhận dữ liệu, hệ thống không nhất thiết đưa toàn bộ dữ liệu thô trực tiếp vào thuật toán ra quyết định. Một bước quan trọng là trích xuất đặc trưng — biến chuỗi đo lường thành những tín hiệu dễ phân tích hơn.
Từ dữ liệu vận động, hệ thống có thể hình thành các đặc trưng như mức hoạt động trung bình, sự thay đổi giữa các ngày hoặc thời gian ít vận động kéo dài. Với dữ liệu ngủ, đặc trưng có thể là thời lượng ngủ, giờ ngủ thường lệ hoặc mức dao động so với những ngày trước. Trong một số kiến trúc machine learning hiện đại, một phần quá trình nhận diện đặc trưng có thể được mô hình tự học từ dữ liệu thay vì được lập trình thủ công.
Bước tiếp theo là tìm mối quan hệ và mẫu lặp lại. AI có thể so sánh dữ liệu hiện tại với ba loại tham chiếu khác nhau:
· Mẫu đã học từ dữ liệu huấn luyện
· Quy tắc hoặc ngưỡng được nhà phát triển tích hợp
· Mức nền hình thành từ chính lịch sử của người dùng
Mức nền cá nhân đặc biệt quan trọng đối với cá nhân hóa. Hai người có cùng một giá trị đo tại một thời điểm chưa chắc cần cùng một gợi ý. Nếu dữ liệu hiện tại bình thường đối với người thứ nhất nhưng khác đáng kể so với lịch sử của người thứ hai, hệ thống có thể xử lý hai trường hợp khác nhau.
Đây cũng là lý do AI không nên được hiểu như một tập hợp các câu lệnh cố định kiểu “nếu A thì luôn khuyên B”. Machine learning có thể kết hợp nhiều tín hiệu và ước lượng khả năng xảy ra một trạng thái hoặc mức độ phù hợp của nhiều lựa chọn. Tuy nhiên, kết quả đó vẫn chỉ phản ánh những gì mô hình học được từ dữ liệu và mục tiêu mà nó được thiết kế để tối ưu.
Hệ thống chọn một gợi ý cá nhân hóa bằng cách nào?
Sau khi nhận diện trạng thái hoặc mẫu dữ liệu, ứng dụng cần chuyển kết quả phân tích thành hành động cụ thể. Đây là lúc mô hình dự đoán và hệ thống khuyến nghị có thể phối hợp với nhau.
Một kiến trúc đơn giản có thể hoạt động như sau:
1. Hệ thống xác định bối cảnh hiện tại của người dùng
2. Mô hình ước lượng gợi ý nào có khả năng phù hợp nhất với bối cảnh đó
3. Các quy tắc an toàn loại bỏ những lựa chọn không phù hợp
4. Hệ thống xếp hạng các phương án còn lại
5. Ứng dụng hiển thị phương án có mức ưu tiên cao nhất
Giả sử mục tiêu của ứng dụng là duy trì hoạt động thể chất. Hai người cùng chưa đạt mục tiêu vận động trong ngày nhưng có lịch sử khác nhau. Một người thường xuyên vận động có thể nhận lời nhắc hoàn thành phần hoạt động còn thiếu; người có mức vận động thấp trong nhiều ngày có thể nhận một mục tiêu nhẹ hơn. Cá nhân hóa nằm ở cách cùng một mục tiêu chung được điều chỉnh theo dữ liệu và bối cảnh riêng, chứ không chỉ ở việc chèn tên người dùng vào một thông báo.
Các hệ thống còn có thể sử dụng phản hồi để cập nhật thứ tự ưu tiên. Nếu người dùng thường bỏ qua một kiểu nhắc nhưng phản hồi tích cực với kiểu khác, dữ liệu tương tác có thể trở thành tín hiệu cho những lần lựa chọn sau. Khi đó, hệ thống không chỉ học “trạng thái sức khỏe” mà còn học cách người dùng tương tác với chính ứng dụng.
Với các hệ thống liên quan đến tập luyện và thiết bị đeo, nghiên cứu tổng quan cho thấy machine learning đang được ứng dụng cho cả theo dõi sinh lý và điều chỉnh khuyến nghị tập luyện theo dữ liệu cá nhân. Tuy vậy, hiệu quả phụ thuộc vào loại cảm biến, dữ liệu, thuật toán và cách hệ thống được đánh giá chứ không thể suy rộng mọi mô hình cho mọi người dùng.
Vì sao cùng một người có thể nhận gợi ý khác nhau theo thời gian?
Một hệ thống cá nhân hóa tốt không chỉ hỏi “người này là ai?” mà còn phải hỏi “trạng thái hiện tại của người này khác trước như thế nào?”.
Vì dữ liệu sức khỏe và hành vi thay đổi liên tục, hồ sơ dùng để tạo gợi ý cũng có thể thay đổi. Mức vận động trong tuần làm việc có thể khác cuối tuần; lịch ngủ có thể thay đổi sau một chuyến đi; một mục tiêu tập luyện có thể trở nên quá nhẹ sau vài tháng duy trì đều đặn.
Do đó, một số ứng dụng sử dụng vòng phản hồi:
Dữ liệu mới → đánh giá lại trạng thái → tạo gợi ý → quan sát phản hồi → cập nhật hồ sơ → tạo gợi ý tiếp theo
Vòng phản hồi giải thích tại sao cá nhân hóa là một quá trình thay vì một lần thiết lập duy nhất. Tuy nhiên, việc cập nhật không nhất thiết có nghĩa mô hình AI tự thay đổi trọng số sau mỗi thao tác của người dùng. Nhiều hệ thống giữ nguyên mô hình nền nhưng cập nhật dữ liệu đầu vào, hồ sơ người dùng hoặc thứ tự các khuyến nghị.
Đây là một khác biệt quan trọng. Nếu một ứng dụng liên tục đưa ra gợi ý khác nhau, điều đó chưa chứng minh rằng thuật toán đang “tự học” theo nghĩa kỹ thuật. Đầu ra cũng có thể thay đổi đơn giản vì dữ liệu mới làm thay đổi bối cảnh mà một mô hình cố định đang đánh giá.
Độ chính xác của gợi ý phụ thuộc vào những yếu tố nào?
Gợi ý của AI không thể đáng tin cậy hơn dữ liệu, mô hình và phạm vi sử dụng mà nó dựa vào. Có bốn nguồn sai lệch chính cần phân biệt.
Dữ liệu đầu vào có thể sai hoặc thiếu. Thiết bị đeo không phải lúc nào cũng ghi nhận hoàn hảo; người dùng cũng có thể nhập thông tin không đầy đủ. Khi tín hiệu đầu vào sai, việc phân tích phía sau có thể vẫn nhất quán về mặt toán học nhưng cho kết luận không phù hợp với thực tế.
Dữ liệu huấn luyện có thể không đại diện đầy đủ cho người dùng hiện tại. WHO cảnh báo rằng dữ liệu thiên lệch hoặc thiếu đại diện có thể khiến hệ thống AI tái tạo hoặc khuếch đại bất bình đẳng. Vì vậy việc đánh giá mô hình phải quan tâm không chỉ đến hiệu suất trung bình mà cả những nhóm người mà dữ liệu huấn luyện chưa phản ánh tốt.
Mô hình có thể nhận diện tương quan mà không hiểu nguyên nhân. Nếu hai tín hiệu thường xuất hiện cùng nhau trong dữ liệu, thuật toán có thể tận dụng mối liên hệ đó để dự đoán. Điều này không tự chứng minh rằng một tín hiệu gây ra tín hiệu kia. Vì thế một khuyến nghị dựa trên dự đoán không nên được diễn giải thành một kết luận y khoa mạnh hơn bằng chứng mà mô hình thực sự có.
Mục đích của sản phẩm quyết định mức độ mà người dùng nên dựa vào kết quả. FDA hiện phân biệt rõ phần mềm phục vụ general wellness với các chức năng liên quan đến chẩn đoán, điều trị hoặc những chức năng phần mềm y tế khác. Hướng dẫn General Wellness của FDA được cập nhật vào tháng 1/2026 nêu rằng phần mềm chỉ nhằm duy trì hoặc khuyến khích lối sống lành mạnh và không liên quan đến chẩn đoán, chữa trị, giảm nhẹ, phòng ngừa hay điều trị bệnh có thể nằm ngoài định nghĩa thiết bị y tế theo các điều kiện áp dụng.
Điều này tạo ra một ranh giới thực tế: một lời nhắc sức khỏe tổng quát và một quyết định lâm sàng không nên được đánh giá theo cùng tiêu chuẩn. FDA cũng có hướng dẫn riêng cho Clinical Decision Support Software, với các tiêu chí khác dành cho phần mềm hỗ trợ quyết định lâm sàng và các chức năng vẫn thuộc phạm vi thiết bị y tế.
Khi nào nên xem gợi ý AI là tham khảo thay vì kết luận?
Gợi ý từ ứng dụng phù hợp nhất khi được hiểu theo đúng mục đích mà hệ thống được thiết kế để thực hiện. Nếu chức năng chỉ theo dõi thói quen và khuyến khích hành vi lành mạnh, đầu ra của nó nên được đọc như một tín hiệu hỗ trợ hành vi, không tự động trở thành chẩn đoán hoặc chỉ định điều trị.
Cần thận trọng hơn khi gợi ý dựa trên dữ liệu thiếu, có sự thay đổi bất thường so với tình trạng thực tế, mâu thuẫn với thông tin từ chuyên gia y tế hoặc yêu cầu người dùng đưa ra quyết định có hậu quả y khoa đáng kể.
Một giao diện trông chắc chắn cũng không chứng minh rằng hệ thống chắc chắn đúng. WHO lưu ý riêng với các mô hình AI tạo sinh rằng đầu ra có thể có vẻ thuyết phục nhưng vẫn chứa lỗi nghiêm trọng; đồng thời các vấn đề về thiên lệch dữ liệu, quyền riêng tư và giám sát chuyên môn vẫn phải được kiểm soát.
Do đó, khi đánh giá một gợi ý từ ứng dụng sức khỏe, người dùng có thể đặt ba câu hỏi: gợi ý dựa trên dữ liệu nào, ứng dụng được thiết kế cho mục đích gì và điều gì xảy ra nếu gợi ý đó sai? Ba câu hỏi này giúp phân biệt một khuyến nghị lối sống có rủi ro thấp với đầu ra cần mức xác thực và giám sát cao hơn.
AI trong ứng dụng sức khỏe tạo gợi ý bằng cách kết hợp dữ liệu của người dùng với các mô hình nhận diện mẫu, dự đoán hoặc xếp hạng lựa chọn. Mức độ cá nhân hóa tăng khi hệ thống có dữ liệu đủ chất lượng, hiểu được mức nền của từng người và cập nhật bối cảnh theo thời gian.
Nhưng AI không “biết” sức khỏe của một người theo cách bác sĩ hiểu bệnh nhân. Nó suy luận từ những tín hiệu mà hệ thống quan sát được và trong phạm vi mô hình đã được thiết kế. Vì vậy giá trị của gợi ý không chỉ phụ thuộc vào thuật toán, mà còn phụ thuộc dữ liệu đầu vào, độ đại diện của dữ liệu huấn luyện, quy tắc an toàn, phạm vi sản phẩm và cách người dùng diễn giải kết quả.
Hiểu chuỗi dữ liệu → đặc trưng → mẫu → dự đoán → lựa chọn gợi ý → phản hồi là cách trực tiếp nhất để thấy AI cá nhân hóa ứng dụng sức khỏe ra sao, đồng thời hiểu vì sao một gợi ý hữu ích vẫn có thể cần giới hạn và sự kiểm chứng phù hợp.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm

